Protéger le serveur SIEM et faire expliquer ses alertes par une IA locale
Le serveur SIEM est la machine la plus sensible du réseau : je l'ai protégé, puis j'ai branché sur Wazuh un modèle de langage local qui explique chaque alerte critique en français.
En bref
Le SIEM de la PME n'avait ni antivirus, ni audit de durcissement, ni sauvegarde, et ses alertes brutes, en anglais, se lisaient mal en plein incident.
J'ai ajouté ClamAV, un audit Lynis hebdomadaire et une sauvegarde Veeam, puis un pipeline local n8n et Ollama qui explique les alertes de niveau 10 ou plus.
Un indice Lynis de 64 sur 100 au premier audit, suivi chaque semaine, 14 jours de sauvegardes, alertes critiques résumées en 3 lignes et une action, sans IA externe.
Contexte
Second volet du projet SOC Wazuh, mené dans la foulée en juin 2026, pour l'entreprise, une PME de distribution d'une vingtaine de personnes. Le serveur SIEM n'était pas protégé : compromis, il livre tous les journaux de sécurité et permet d'effacer des traces ; perdu, il emporte règles, intégrations et historique.
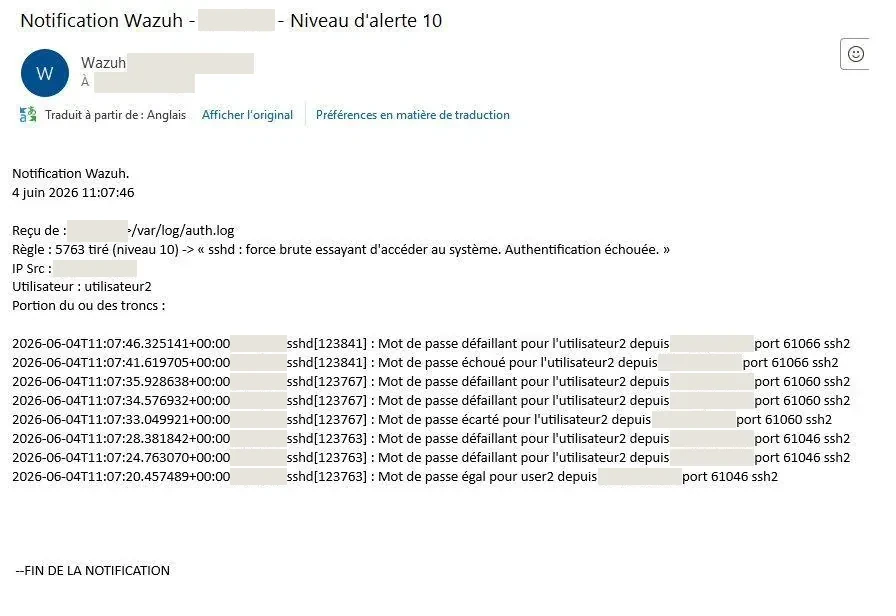
Ses alertes étaient denses : identifiants de règles, journaux en anglais, à décoder en plein incident. Deux contraintes : rien à acheter, et aucune alerte envoyée à un service d'IA externe.
Ce que j'ai fait
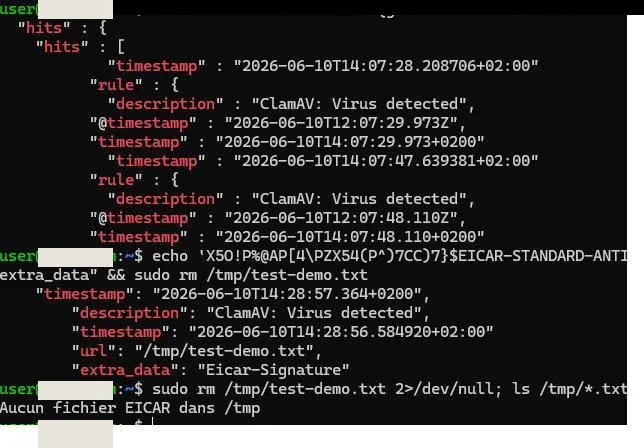
- Un antivirus pour le serveur lui-mêmeClamAV analyse chaque nuit les répertoires sensibles et écrit au format qu'attend le décodeur de Wazuh. Un fichier de test EICAR a bien levé l'alerte « ClamAV: Virus detected ».
- Mesurer le durcissementLynis audite le serveur chaque dimanche : un premier indice de 64 sur 100, sur 275 tests, celui d'un Ubuntu jamais durci, sert de référence. Une dérive de configuration se voit comme une baisse du score.
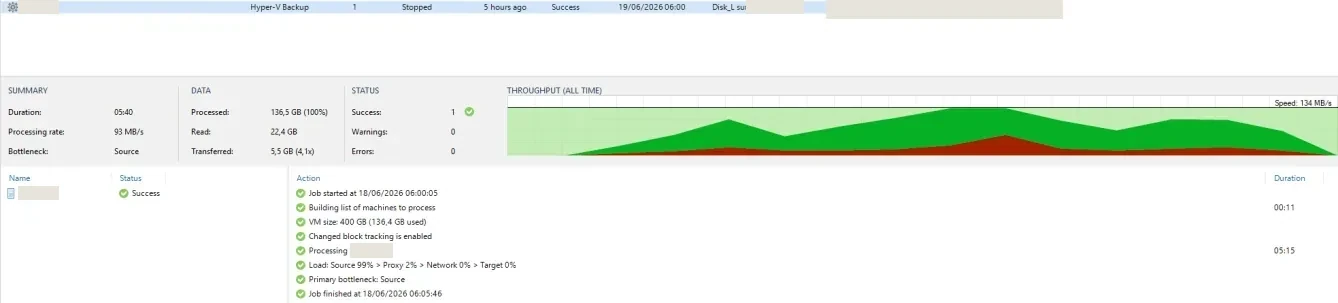
- Sauvegarder le SIEML'agent Linux de Veeam ne pouvait pas prendre de snapshot : job natif par l'intégration Hyper-V, avec suivi des blocs modifiés et 14 jours de rétention.
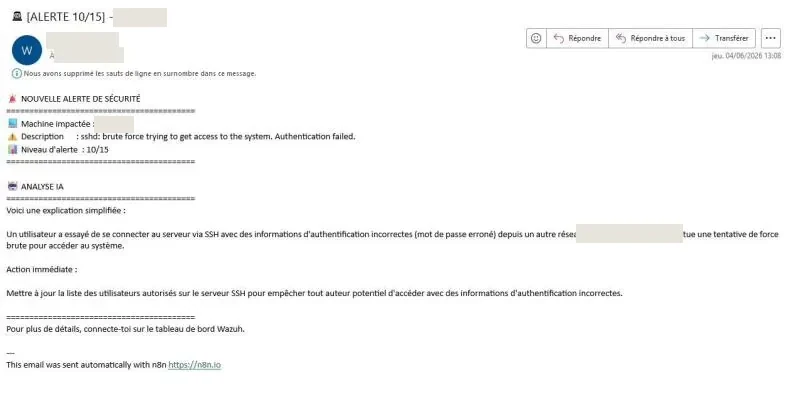
- Faire expliquer les alertesÀ partir du niveau 10, Wazuh appelle n8n, qui interroge le modèle llama3.2:3b sur le serveur : trois lignes en français au plus, puis une action concrète.
- Encadrer le modèleSur les descriptions de règles au jargon dense, il complétait par des formules plausibles, jusqu'à inventer une règle de conformité. Prompt durci, température abaissée, et rejet de toute traduction plus longue que 2,2 fois l'original.
Voir les détails techniques
ClamAV. Le moteur clamd reste en mémoire, freshclam met à jour les signatures plusieurs fois par jour. À 3 h, un script lancé par cron analyse les répertoires utilisateurs, les scripts installés à la main, /tmp, le répertoire de Wazuh et /root. Le décodeur fourni avec Wazuh (0075-clamav_decoders.xml) ne reconnaît une ligne que si elle porte le nom de programme clamd : le script écrit exactement ce préfixe, faute de quoi le fichier remonterait sans qu'aucune détection ne se déclenche.
Wazuh · ossec.conf
<localfile>
  <log_format>syslog</log_format>
  <location>/var/log/clamav/daily-scan.log</location>
</localfile>
Bash · validation de bout en bout
# 1. Fichier de test EICAR, inoffensif, reconnu par tous les antivirus
#    (chaîne omise ici : elle ferait réagir l'antivirus de votre poste)
echo '<chaîne de test EICAR>' > /tmp/eicar-test.txt

# 2. Lancer l'analyse comme le fait cron
sudo /opt/clamav-scan.sh

# 3. Vérifier que Wazuh a produit l'alerte
sudo grep "52502" /var/ossec/logs/alerts/alerts.json | tail -1 | python3 -m json.tool
Règle 52502, niveau 8 sur 15, sur l'agent 000 (le serveur lui-même) ; trois alertes de ce type indexées pendant la validation, puis aucun fichier de test resté dans /tmp.
Lynis. Pare-feu et ClamAV bien repérés. Parmi les avertissements, une synchronisation de l'heure en retard, corrigée par un redémarrage du service et confirmée au scan suivant. Wazuh lit la sortie de Lynis, et le bilan quotidien affiche l'indice dans un bandeau coloré selon son niveau.
cron · /etc/cron.d/lynis-weekly
# Dimanche, 4 h
0 4 * * 0 root lynis audit system --cronjob > /dev/null 2>&1
L'agent Linux de Veeam ne peut pas prendre de snapshot
Le module noyau nécessaire aux snapshots de volume ne se chargeait pas sur la version du noyau en place, malgré le paquet installé.
Sauvegarder de l'intérieur impose un module dans le système invité ; Veeam sait traiter Hyper-V de l'extérieur. Job natif par l'hyperviseur, sans rien installer dans Ubuntu, Changed Block Tracking activé : première sauvegarde complète sans erreur ni avertissement.
L'entreprise utilisait déjà Veeam Backup & Replication pour ses VM Windows, un outil vu en BTS dans un projet de sauvegarde et de restauration de VM. Effet de bord : la connexion SSH de Veeam au serveur a déclenché une alerte Wazuh de connexion réussie. Les connexions SSH sont bien surveillées, et un outil légitime produit lui aussi des alertes.
Pipeline IA. Ollama exécute le modèle sur place ; llama3.2:3b, environ 2 Go, tourne sur le processeur, la VM n'ayant pas de carte graphique. n8n, un orchestrateur low-code, reçoit l'alerte en JSON (niveau, machine, règle, horodatage, adresse source), interroge le modèle et compose l'e-mail : détails techniques, explication et action recommandée.
Wazuh · ossec.conf (chemin du webhook masqué)
<integration>
  <name>custom-n8n</name>
  <hook_url>http://localhost:5678/webhook/<chemin></hook_url>
  <level>10</level>
  <alert_format>json</alert_format>
</integration>
Les alertes reçues en Syslog ne partent pas
Les alertes des agents arrivaient dans n8n, pas celles des sources Syslog. Par défaut, ce mécanisme d'intégration ignore l'agent 000, le manager lui-même, auquel tout le Syslog est rattaché.
Un second bloc d'intégration qui cible l'identifiant de la règle au lieu de l'agent. La méthode vaut pour toute nouvelle source Syslog.
Bilan quotidien. Volumes par gravité, machines les plus actives, types d'alertes fréquents, une fiche par type d'alerte critique. La version erronée annonçait 358 alertes de niveau 8 ou plus ; une requête directe à l'indexer donnait le chiffre du tableau de bord. La réécriture garde la présentation, avec une fonction de requête partagée par toutes les sections. Au passage : ordre chronologique corrigé, repli pour l'adresse source des alertes Syslog, agrégation côté serveur pour le volume Suricata, qui plafonnait à la taille maximale d'une requête. J'ai ajouté une corrélation : une adresse IP vue par plusieurs sources en 24 heures est un signal plus fort qu'une détection isolée.
Traductions. Une description portant sur un paquet réseau hors séquence est revenue avec une règle de conformité inventée. Le prompt durci impose une traduction littérale, sans information absente du texte source ; sur les cas observés, le contrôle de longueur trahissait bien les hallucinations. Les signatures techniques, comme « ET SCAN Potential SSH Scan », restent en anglais, comme dans l'usage de la profession.
L'incident
184 alertes critiques simulées, aucune dans le bilan du matin
Chaque matin à 9 h, un script envoie le bilan des 24 heures. La veille, j'avais simulé 184 alertes de niveau 12 ou plus ; le bilan n'en comptait aucune de niveau 11 ou 12.
Le script lisait un fichier local incomplet, et un bloc except avalait en silence les erreurs JSON. Je l'ai réécrit pour interroger l'indexer de Wazuh, la même source que le tableau de bord.
Résultats
Une alerte critique arrive désormais en français : ce qui s'est passé, en trois lignes, et l'action à faire tout de suite. L'analyse reste sur le serveur ; l'e-mail final passe par la messagerie Microsoft 365 de l'entreprise.
Ce pipeline enrichit l'alerte, il ne répond pas : rien n'est bloqué ni isolé automatiquement. Le temps de réponse du modèle sur processeur n'a pas été mesuré. Pour une vue d'ensemble rapide, une page HTML de synthèse est régénérée chaque minute.
Ce que j'améliorerais
- Isoler l'enrichissement : sur un prochain déploiement, je placerais l'orchestrateur et le modèle sur une VM séparée, avec un compte limité à la lecture des alertes ; chaque service ajouté au SIEM est une surface d'attaque de plus. Et je lirais chaque script d'installation avant de l'exécuter, plutôt que
curl | sh. - Mesurer après chaque correction : appliquer les suggestions de Lynis par lots et noter le score après chaque lot.
- Prouver la sauvegarde par la restauration : restaurer la VM sur un réseau isolé d'Hyper-V et chronométrer l'opération.
Compétences
Pour aller plus loin
- Le bilan du matin qui oubliait 184 alertes critiques : 184 alertes critiques simulées, aucune dans le bilan du matin. Un fichier local incomplet, un bloc except qui avalait les erreurs, et un script réécrit sur l'indexer.
- Une IA locale qui invente une règle de conformité : Un modèle de langage local, branché sur le SIEM, ajoute une règle de conformité absente du texte qu'il traduit. Trois garde-fous, et une décision qui reste humaine.